WireGuard 从 PVE 迁移到 Docker 中遇到的问题以及解决思路
家里有两套 WireGuard,本来就是图个方便,结果前两天差点把我送走。
一套跑在 UBNT Fiber 上,兼着家里的主路由,用了很久,一直稳。另一套是后来迁过来的,本来跑在 PVE 里,跑了大半年一点毛病没有。前阵子嫌 PVE 里维护麻烦,就把它整个搬进了飞牛的 Docker。搬完之后连着几次是能用的,直到上周我在外面想连回家看导航页,连不上。切回主路由那套,秒连。
同一个客户端,同一台电脑,同一个目标,一个通一个不通。这就有点意思了。
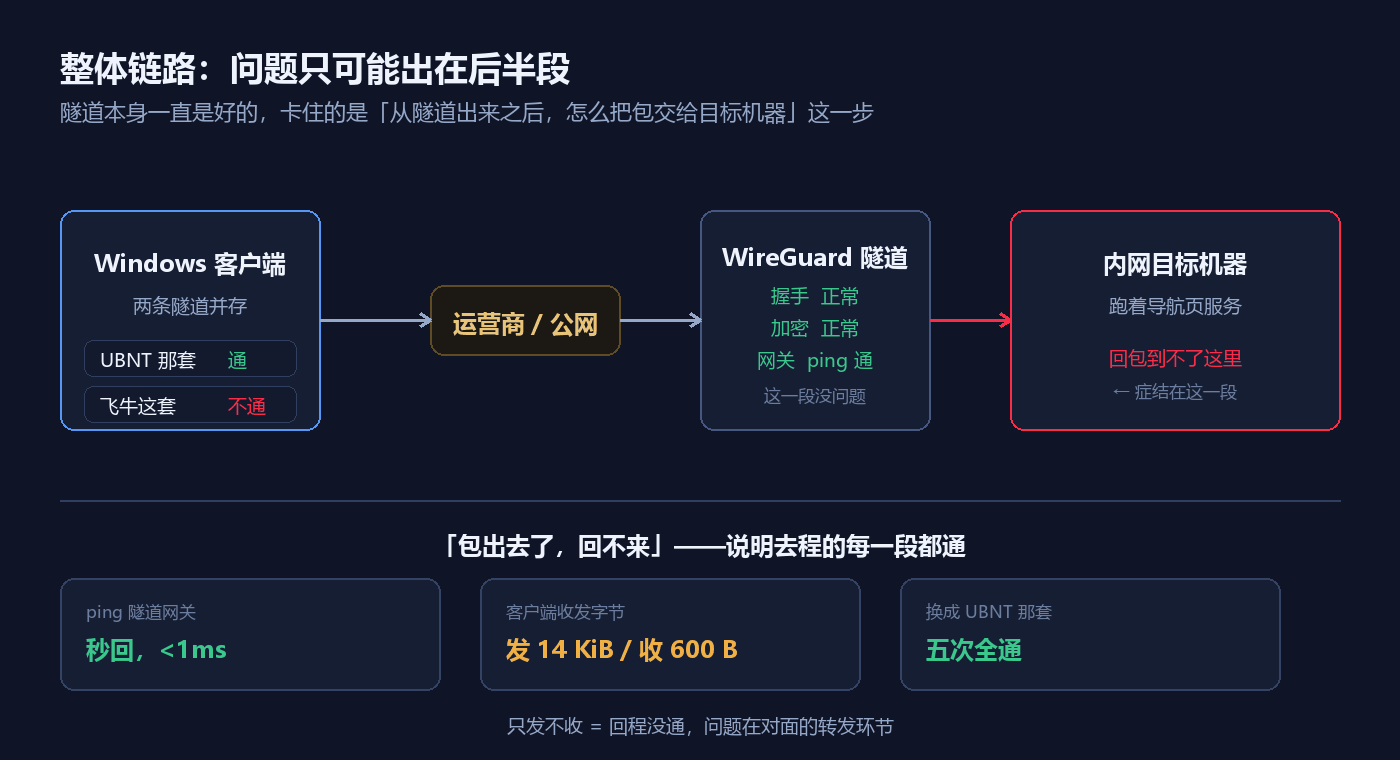
先把结论摆在前面,省得跟着我绕:隧道这一段从头到尾都是好的,卡住的是「包从隧道出来之后,怎么交给目标机器」这一步。
先说我一开始查错的方向
我第一反应是路由冲突。
原因很朴素:两套隧道下发的网段是重合的,都带了一整个内网段。Windows 上的 WireGuard 会把这些网段写进路由表,两条路由 metric 一样、前缀一样,后启用的那条把前面的盖掉。我当时打开路由表一看,果然是这样——内网段指向的是 UBNT 那套隧道,那我这台机器的 IP 包压根没往飞牛那套隧道里走,连不上太合理了。
思路没问题,动作也没问题。我把飞牛那套的 AllowedIPs 从整段收窄成单机(就是那台跑导航页的机器),让它的前缀比另一条路由更精确,这样按最长前缀匹配,选路就该对了。
结果——还是不通。
这就说明我之前那个方向顶多算个次要矛盾。真正的问题不在这儿。
排掉一个嫌疑人之后,剩下的线索变得很清楚
既然路由是通的,那就说明包确实进了隧道。这时候最有用的一招,是把两条隧道的现状摆在一起比。
第一件事,ping 对端的隧道网关。秒回,延迟不到 1 毫秒。
这一下就排掉了一大片可能性:握手正常、密钥正常、端口映射正常、运营商那边也没做手脚——隧道本身是活的。
第二件事,看客户端侧的数据统计。发送出去了十几 KiB,收到只有几百字节。
几百字节是什么概念?基本就是握手包的量级。也就是说,我这边的请求都发出去了,对面一个回包都没回来。
第三件事,换上 UBNT 那套隧道,ping 同一个目标,全通,TTL 正常。
三条线索一摆,指向就很明确了:隧道是好的,问题出在对面把包从隧道里拿出来之后,没能把它递到目标机器手上。 也就是转发。
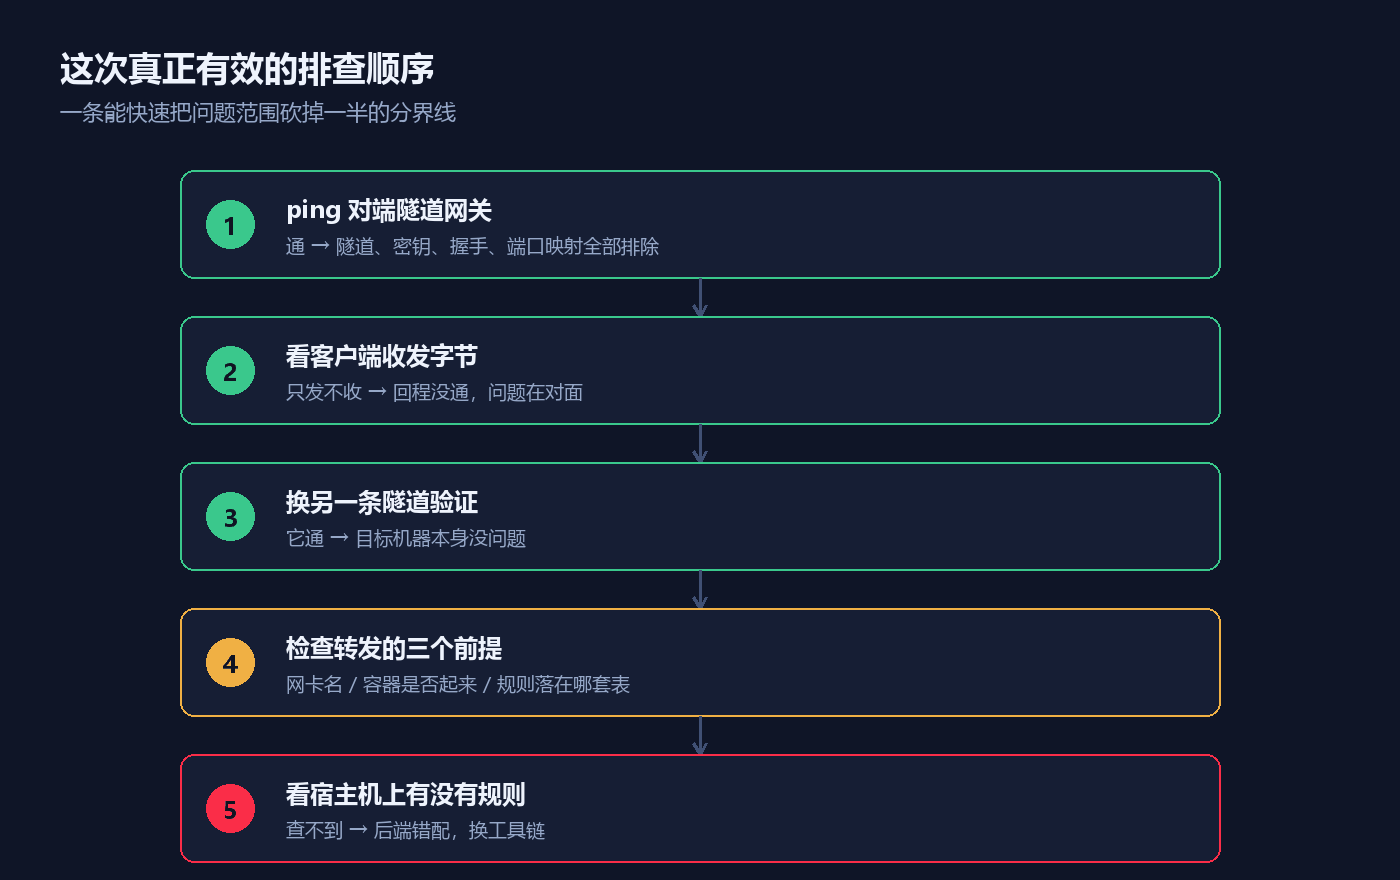
这三步其实是有顺序的,顺序本身就是信息量——它能把「隧道问题」和「转发问题」干脆地切开,省掉一大堆瞎猜:
但真正让我卡住的,是飞牛这边
按理说这是典型的转发没做——容器里的 ip_forward 没开,或者 NAT 规则没生效。补上就行。
问题是,我检查的时候这些全都在。
这不是见鬼了么。规则明明写着,但就是不干活。
这里我得提一个我浪费了很久的坑:我之前在容器的启动配置里加了 sysctls,结果容器根本起不来,报了一句大概是「host 网络命名空间下不允许设置这个 sysctl」。因为容器的 network 模式是 host,Docker 直接拒绝这类设置。删掉之后容器正常起来了,而且宿主机本身已经开了转发,不需要容器再设一遍。
但清掉这个障碍之后,问题照旧。规则在、转发开着、隧道活着,包出得去回不来。
后来发现是三个问题叠在一起
把事情彻底解决之后回头看,一共是三层,而且是叠着的——任何一层单独存在都够让你连不上,这也是为什么我一开始判断错方向:修好一层,症状没变,就以为修错了。
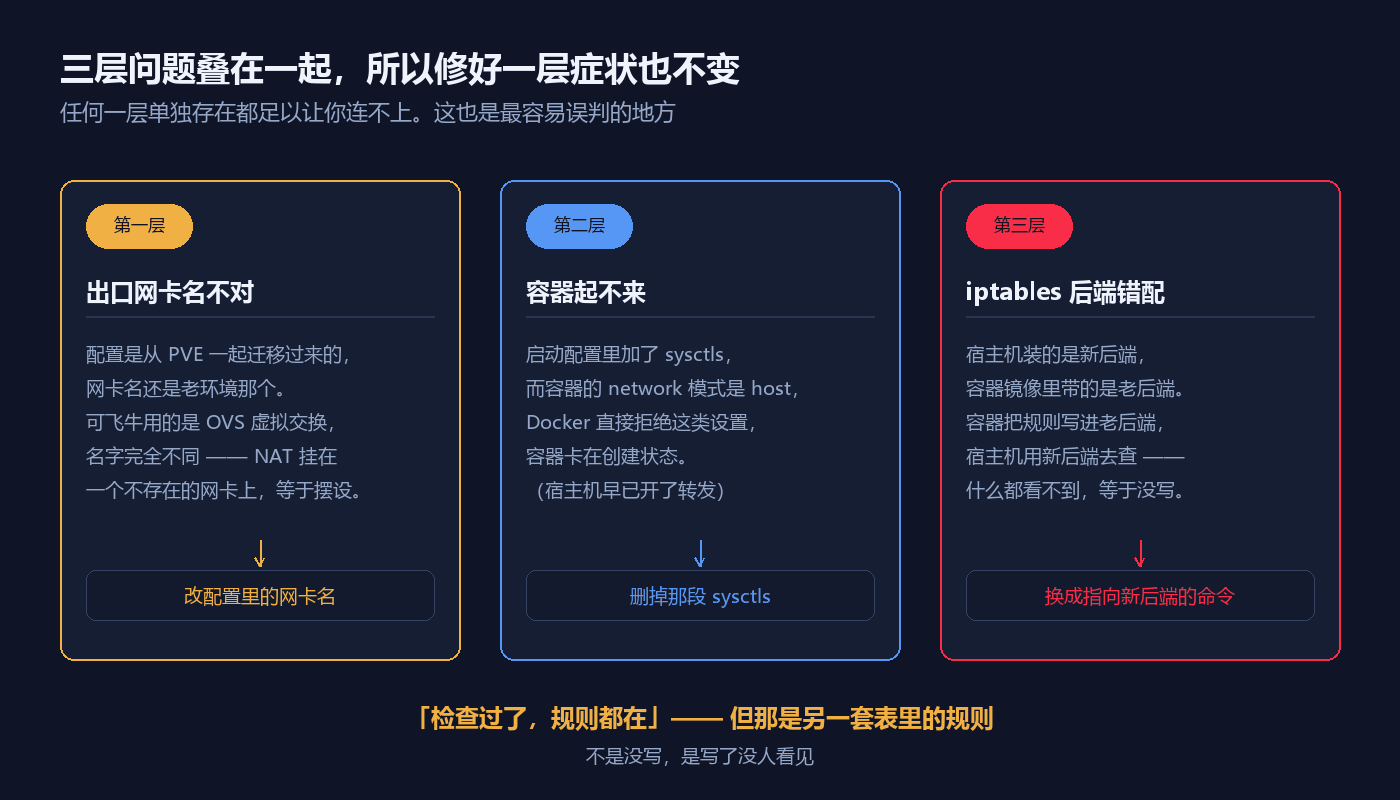
第一层,网卡名。 这套导航页的老家在 PVE,配置里的出口网卡是从那边一起迁过来的,在 PVE 上确实是这个名字。但飞牛的网络是另一套东西——它用的是 OVS 那套虚拟交换,实际出口网卡名字完全不一样。于是 NAT 规则挂在一个根本不存在的网卡上,等于摆设。
第二层,容器启动配置。 就是上面说的那个 sysctls,在 host 网络模式下会被 Docker 直接拒绝,容器卡在创建状态。这个反而最好发现,因为它压根起不来。
第三层,也是最阴的一个——iptables 后端不一样。
这个是真花时间。现象是:我在容器里敲 iptables -t nat -L,规则一条不少,写得明明白白。回到宿主机敲同一条命令,什么都看不到。
同一个内核,同一条命令,两个结果。看着像灵异事件,其实是 iptables 两条腿走路留下的历史包袱:现在系统里有 legacy 和 nftables 两套后端,写规则时如果工具链选的后端不一样,规则就落到不同的表里。宿主机上装的是新后端,容器镜像里带的是老后端。容器把规则写进老后端,宿主机用新后端去查,自然什么都查不到——对宿主机来说,这些规则等于不存在。
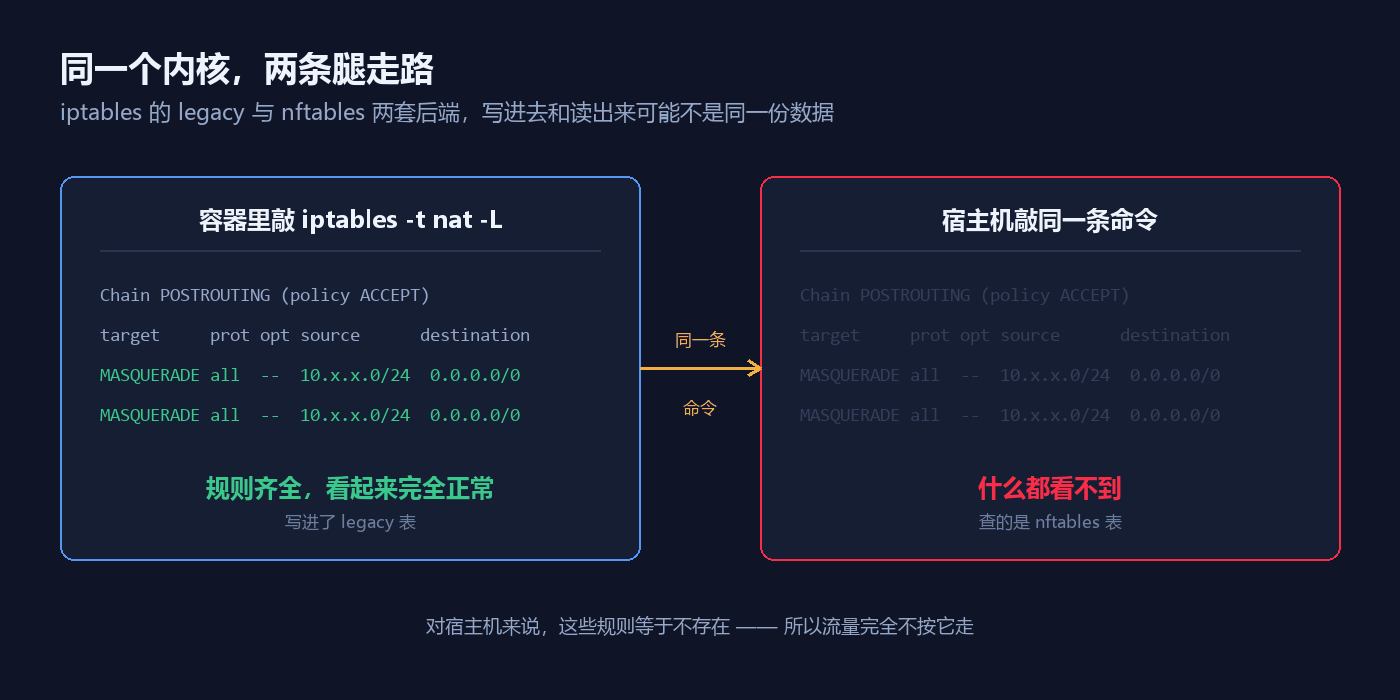
这也是为什么整件事这么难判断:不是「规则没写」,是「写了但没人看见」。你检查的时候一切正常,可流量就是不按它走。
最后是怎么改的
定位清楚之后,改动其实很小,就三处:
一是把配置里的出口网卡改成飞牛实际的网卡名,并在容器环境变量里也显式指定一遍。
二是把启动配置里那段 sysctls 删掉,宿主机已经开了转发,不需要重复设置。
三是把生成规则用的命令从老后端的 iptables 换成指向新后端的绝对路径。这一步一改,宿主机上立刻就能看见规则了。
另外顺便记一个容易踩的点:这个版本的管理面板把启动脚本存在自己的数据库里,不再读环境变量里的那套配置了。所以别想着改环境变量了事,得去动数据库里那份。还有一个反直觉的:用 wg syncconf 这种方式重载配置时,启动脚本是不执行的——你改完以为生效了,其实没有。
改完之后,宿主机上能看到 NAT 规则和转发规则,并且带上了流量计数;客户端 ping 目标机器,五次全通,延迟三四十毫秒。重启容器,规则自动恢复,还是通的。
到这才算真的修完。
几条这次学到的东西
第一,「能不能 ping 通隧道网关」是一个非常高效的分界线。 它通,说明隧道、密钥、握手、端口映射全都没问题,你可以把注意力整个挪到对面的转发和路由上。它不通,那就完全不用查转发,先看隧道本身。
第二,客户端的收发字节数会说话。 只发不收,基本就是「回程没通」;发得少而收得多,那是另一边的问题。这个数字比 ping 结果信息量大得多。
第三,不要假设迁移过来的配置还能用。 跨平台、跨宿主的迁移,最危险的不是配置丢了,而是配置还在、还长得挺像,只是里面有一两个值是照着老环境写的。这类错误不会报错,只会静默失效。
第四,也是我这次最想记住的一条:同一个系统里有新旧两套同类机制时,要习惯性地问一句「我改的是哪一套」。 这次踩的坑本质就是这个——工具链悄悄分岔了,你写的和你查的不是同一份数据。
最后说一句,这套飞牛的配置我全程没动底层。飞牛自己那套网络和系统设置我一下都没碰,动过的只有这个容器自己的配置文件,改之前也整份备份了。Docker 化的服务出问题,绝大多数时候在容器这一层就能解决,别急着往下挖。